 flemming-it
f1652cce62
Fetch one German federal law from gesetze-im-internet.de (BMJ) by its
site slug, unpack the BMJ norm XML from the site's xml.zip and return
it content-addressed (SHA-256) plus the BMJ builddate, so a flow's
audit trail pins the exact Gesetzesstand it processed.

- xml.zip unpack picks the largest XML entry (norm body)
- lying ZIP size header rejected instead of silently truncated
  (audit integrity); 64 MB unpack cap, 96 MB download cap
- net permission pinned to www.gesetze-im-internet.de; no auth
- 11 unit tests (no network), wasm32-wasip2 build green

Signed-off-by: flemming-it <sf@flemming.it>
1.9 KiB
source.bundesrecht
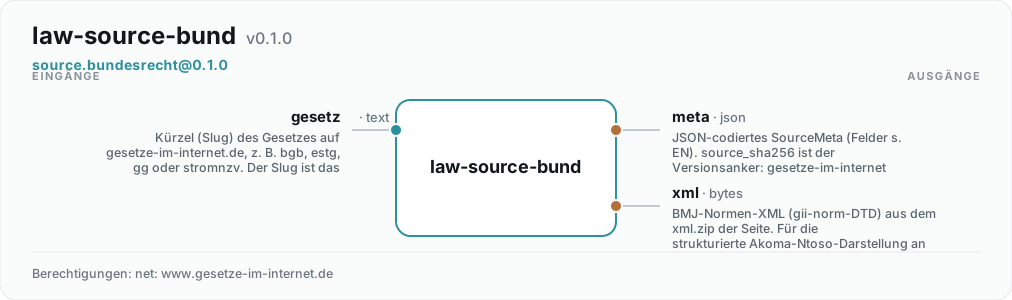
Deutsches Bundesrecht von gesetze-im-internet.de per Kürzel holen
Was es tut
Löst ein gesetze-im-internet.de-Kürzel (z. B. bgb, estg, gg,
stromnzv) gegen die öffentliche BMJ-Publikationsseite auf, lädt das
xml.zip des Gesetzes, entpackt das BMJ-Normen-XML (gii-norm-DTD)
und liefert es samt Metadaten. Die entpackten Bytes sind
inhaltsadressiert (SHA-256) — das Prüfprotokoll des Flows hält den
exakt verarbeiteten Gesetzesstand fest.
Anders als EUR-Lex liefert gesetze-im-internet nur den AKTUELLEN
konsolidierten Stand — es gibt keine URL für ältere Fassungen. Der
SHA-256 (plus das BMJ-builddate aus dem XML-Kopf) macht einen
späteren Re-Fetch vergleichbar: Eine Änderung upstream wird sichtbar
statt still.
Nur öffentliche BMJ-Daten; die Netzwerk-Berechtigung ist auf
www.gesetze-im-internet.de festgelegt.
Verwendung
steps:
  - id: fetch
    use: source.bundesrecht@^0
    with:
      gesetz: stromnzv

  - id: normalize
    use: text.akoma-normalize@^0
    with:
      content: $fetch.xml
Das Kürzel ist das Pfadsegment der Gesetzes-Seite auf
gesetze-im-internet.de: https://www.gesetze-im-internet.de/<slug>/.
Ausgaben
xml— das BMJ-Normen-XML wie aus dem Archiv der Seite entpackt. Für die strukturierte Akoma-Ntoso-Darstellung antext.akoma-normalizeweiterreichen (dessen BMJ-Adapter aus v0.1 versteht dieses Format nativ).meta— JSON-SourceMeta:gesetz,url,source_sha256,byte_lenundbuilddate, sofern der XML-Kopf eines trägt.
Fehler
- Unbekanntes Kürzel → klare Eingabefehler-Meldung mit der geprüften URL.
- Kein ZIP, kein XML im Archiv, HTML-Fehlerseiten → interner Fehler mit Ursache; HTML wird nie an nachgelagerte Schritte durchgereicht.